Proyecto Fin de Master
Trabajo fin de máster: reseñas de dos juegos de Google Play analizadas con NLP (sentimiento, temas con LDA y series temporales) para proponer mejoras.
Análisis de Comentarios de Usuarios en aplicaciones de la Google Play
Alcance del proyecto
Extracción y análisis de datos de comentarios y calificaciones de usuarios de dos aplicaciones móviles de juego en la Google Play Store utilizando técnicas de web scraping y procesamiento de lenguaje natural (PNL).
Identificación de temas, sentimientos y tendencias clave en las opiniones de los usuarios a través de análisis de sentimiento, modelado de temas (LDA) y análisis de series de tiempo.
Formulación de recomendaciones de mejora específicas para las aplicaciones basadas en los insights obtenidos del análisis de los comentarios.
Estimación del impacto económico potencial de implementar las recomendaciones propuestas en términos de ingresos incrementales y reducción de costos.
Resumen
Este trabajo se enfoca en realizar un análisis de dos aplicaciones de juego de la tienda Google Play, utilizando comentarios y calificaciones para orientar las mejoras y optimizaciones necesarias previas al lanzamiento oficial en el mercado.
Se desarrolló y aplicó un código en python diseñado para extraer los datos directamente de la Google Play Store mediante su API, asegurando la recopilación de información actualizada y pertinente.
Los datos recopilados pasaron por un proceso riguroso de preprocesamiento y fueron sometidos a técnicas avanzadas de análisis, incluyendo el análisis de sentimiento y modelado de temas (LDA). Esta metodología nos permitió identificar con precisión áreas críticas de oportunidad, errores prevalentes y aspectos de las aplicaciones que requieren mejoras sustanciales. Se identificaron palabras clave y temas recurrentes, que se centraron principalmente en problemas técnicos y aspectos de la interfaz de usuario.
Además, este estudio va más allá de la identificación de áreas de mejora, también estimando el impacto económico potencial que las optimizaciones sugeridas podrían conllevar. Se realizó un análisis cuantitativo para prever cómo las mejoras propuestas podrían influir positivamente en la rentabilidad y el éxito comercial de las aplicaciones.
Finalmente, se delinean estrategias y direcciones futuras con el objetivo de perpetuar el ciclo de mejora y optimización. Se proponen recomendaciones concretas para refinar el análisis y expandir la investigación, permitiendo una adaptación y evolución continuas de las aplicaciones basándose en el feedback directo y las necesidades cambiantes de los usuarios.
Objetivos
El principal objetivo de este Trabajo es aplicar métodos analíticos avanzados para evaluar la experiencia del usuario en dos aplicaciones de juego. Esto se logrará a través de los siguientes sub-objetivos:
Desarrollar e Implementar Herramientas de Extracción de Datos:
Crear código específico para extraer de manera eficiente y sistemática comentarios y calificaciones de usuarios de la Google Play Store utilizando su API. También para apoyar en la solución de los puntos siguientes.
Análisis Exhaustivo de los Datos:
Hacer un preprocesamiento y aplicar técnicas de análisis de sentimiento y modelado de temas para interpretar y comprender mejor los comentarios y calificaciones de los usuarios.
Identificación de Áreas de Mejora:
Identificar y analizar áreas críticas, errores y aspectos que requieren mejoras o refinamientos dentro de las aplicaciones, basándose en el feedback directo de los usuarios.
Extras:
Evaluación del Impacto Económico:Estimar el impacto económico potencial de las mejoras propuestas, analizando cómo las optimizaciones sugeridas podrían influir en la rentabilidad y éxito comercial de las aplicaciones.
Proposición de Estrategias de Optimización:
Proponer futuras direcciones y estrategias de mejora continua, asegurando que las aplicaciones evolucionen de manera alineada con las necesidades y expectativas cambiantes de los usuarios.
A través de estos objetivos, este TFM busca proporcionar recomendaciones accionables y estratégicas que puedan ser empleadas para mejorar la funcionalidad, diseño y experiencia de usuario de las aplicaciones analizadas, contribuyendo así a su éxito y aceptación en el mercado.
Metodología
Se implementó un código en python con un pipeline completo de NLP y análisis de sentimiento sobre los datos.
Desarrollar y Implementar Herramientas de Extracción de Datos
Obtención de datos: Utilizamos la librería google-play-scraper para obtener los comentarios de la app especificada por su ID, así como nombre, desarrollador, y otros datos generales.
from google_play_scraper import app, reviews

# Obtener ID de la app
app_id = 'com.example.app'

# Obtener detalles de la app
app_result = app(app_id)
app_name = app_result['title']
app_developer = app_result['developer']

# Obtener comentarios
comments = reviews(app_id, count=1000)

# Guardar comentarios en CSV
df = pd.DataFrame(comments)
df.to_csv('comments.csv', index=False)
Este código utiliza la librería google-play-scraper para obtener el nombre, desarrollador y otros detalles de la aplicación a partir de su ID. También obtiene los comentarios de la app especificada y los guarda en un archivo CSV.
Análisis Exhaustivo de los Datos
Preprocesamiento: Limpieza de texto: elimina signos de puntuación, convierte a minúsculas, etc. Drop de comentarios que no estén en inglés y lematización de palabras.
import re
from nltk.stem import WordNetLemmatizer

# Función para limpiar el texto
def preprocess_text(text):
    # Convertir a minúsculas
    text = text.lower()
    # Eliminar signos de puntuación
    text = re.sub(r'[^\w\s]', '', text)
    # Tokenizar
    tokens = word_tokenize(text)
    # Lematizar
    lemmatizer = WordNetLemmatizer()
    lemmas = [lemmatizer.lemmatize(token) for token in tokens]
    return ' '.join(lemmas)

# Aplicar la función a los comentarios
data['clean_text'] = data['text'].apply(preprocess_text)

# Quitar comentarios que no estén en inglés
data = data[data['language'] == 'en']
Este código limpia el texto convirtiéndolo a minúsculas, eliminando signos de puntuación, tokenizando y lemmatizando las palabras. También filtra para quedarse solo con comentarios en inglés.
Análisis Exhaustivo de los Datos e Identificación de Áreas de Mejora
Análisis de Sentimiento: Usa VADER para calcular polaridad de los comentarios. Clasifica el sentimiento en positivo, negativo y neutro. Agrega un lexicon personalizado.
from vaderSentiment.vaderSentiment import SentimentIntensityAnalyzer

# Crear un objeto SentimentIntensityAnalyzer
analyser = SentimentIntensityAnalyzer()

# Actualizar el lexicón con palabras personalizadas
analyser.lexicon.update(custom_lexicon)

# Aplicar VADER a los comentarios
data_copy['Negative_VADER'] = data_copy['Content'].apply(sentiment_analyzer_scores).apply(lambda x: x[0])
data_copy['Neutral_VADER'] = data_copy['Content'].apply(sentiment_analyzer_scores).apply(lambda x: x[1])
data_copy['Positive_VADER'] = data_copy['Content'].apply(sentiment_analyzer_scores).apply(lambda x: x[2])
data_copy['Compound_VADER'] = data_copy['Content'].apply(sentiment_analyzer_scores).apply(lambda x: x[3])

# Clasificar el sentimiento en positivo, negativo o neutro
data_copy['Sentiment'] = data_copy['Compound_VADER'].apply(classify_sentiment)
Este código crea un objeto VADER, actualiza el lexicón, aplica VADER para calcular la polaridad de los comentarios, y finalmente clasifica el sentimiento en positivo, negativo o neutro según el puntaje de polaridad compuesto.
Análisis Exploratorio: Calcula estadísticas como puntuación promedio. Visualizaciones como histogramas, wordclouds y evolución temporal del sentimiento.
# Análisis Exploratorio
# Calcular puntuación promedio
avg_rating = df['rating'].mean()

# Histograma de puntuaciones
df['rating'].hist()

# Wordcloud de texto positivo y negativo
wc_positive = WordCloud().generate(df[df['sentiment'] == 1]['text'])
wc_negative = WordCloud().generate(df[df['sentiment'] == 0]['text'])

# Sentimiento promedio por fecha
df.groupby('date')[['compound']].mean().plot()
El código de análisis exploratorio calcula estadísticas, crea visualizaciones y analiza la evolución del sentimiento.
Modelado de Temas: Usa LDA para identificar los temas principales en los comentarios. Entrena el modelo y evalúa su calidad. Visualiza los temas e importancia de las palabras.
# Modelado de Temas con LDA
from gensim.models import LdaModel
from gensim import corpora

# Preprocesar texto
doc_clean = [preprocess_text(doc) for doc in df['text']]

# Crear diccionario y corpus
dictionary = corpora.Dictionary(doc_clean)
corpus = [dictionary.doc2bow(text) for text in doc_clean]

# Entrenar modelo LDA
lda = LdaModel(corpus, num_topics=5)

# Evaluar con perplejidad y coherencia
print(lda.log_perplexity(corpus))
coherence = CoherenceModel(model=lda, texts=doc_clean, dictionary=dictionary)
print(coherence.get_coherence())

# Visualizar topics
pyLDAvis.enable_notebook()
vis = pyLDAvis.gensim.prepare(lda, corpus, dictionary)
pyLDAvis.display(vis)
El código de LDA preprocesa el texto, entrena un modelo de tópicos, evalúa su calidad y visualiza los tópicos encontrados.
Clasificación de Sentimiento: Entrena modelos de Random Forest y SVM para clasificar sentimiento.
Calcula métricas de rendimiento como precisión y curva ROC.
# Seleccionar características (columnas VADER y Score) y la columna de sentimiento
features = ['Compound_VADER', 'Negative_VADER', 'Neutral_VADER', 'Positive_VADER', 'Score']
X = data_copy[features]
y = data_copy['Sentiment']

# Dividir los datos en conjuntos de entrenamiento y prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=45)

# Entrenar un modelo Random Forest Classifier
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)

# Realizar predicciones en el conjunto de prueba
y_pred = clf.predict(X_test)

# Evaluar el rendimiento del modelo
accuracy = accuracy_score(y_test, y_pred)
print(classification_report(y_test, y_pred))
print(confusion_matrix(y_test, y_pred))
Este código selecciona las características relevantes, divide los datos en entrenamiento y prueba, entrena un modelo Random Forest Classifier, realiza predicciones en el conjunto de prueba y evalúa el rendimiento calculando la precisión, el reporte de clasificación y la matriz de confusión.
El código está disponible para su visualización en el servicio web: Jupyter nbviewer: LINK
Resultados
Aplicación 1: Real Car Driving: Race City 3D (com.v06.car.driving.mega.city)
Se obtuvieron 5712 y se analizaron 2726 comentarios ya que por una parte se descartaron otros idiomas distintos del inglés y se acotó las fechas al período 2023-07-29 a 2023-09-09.
La puntuación promedio de los comentarios fue de 4.5 estrellas. Esto se compara con la puntuación promedio de la app en la Play Store de 4.2 estrellas.
Total de comentarios: 2718
Comentarios positivos: 1505
Comentarios negativos: 840
Comentarios neutros: 373
Proporción de comentarios positivos: 55.0 %
Proporción de comentarios negativos: 31.0 %
Proporción de comentarios neutros: 14.0 %
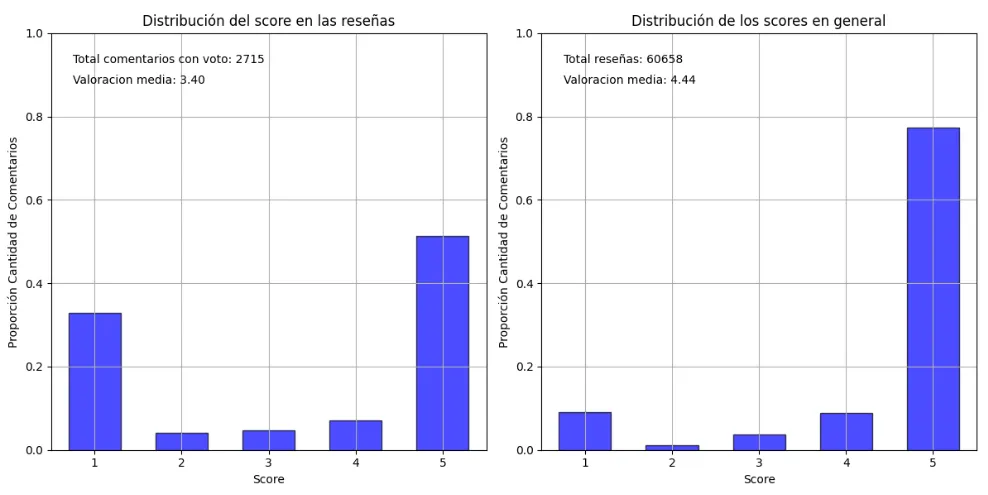
El análisis de sentimiento con VADER mostró que el 47% de los comentarios fueron positivos, el 36% negativos y en consecuencia el 17% fue neutro.
Comentario más positivo : 1.0
Comentario más negativo : 0.43
Comentario más positivo: cool
Comentario mas negativo: This game was not good 👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎👎
Al clasificar el sentimiento, se observó que la proporción de comentarios positivos/negativos varió a lo largo del tiempo, especialmente cerca de las fechas en las que hubo actualizaciones de la app. Esto sugiere que las actualizaciones tuvieron un impacto en la percepción de los usuarios en la mayoría de los casos.

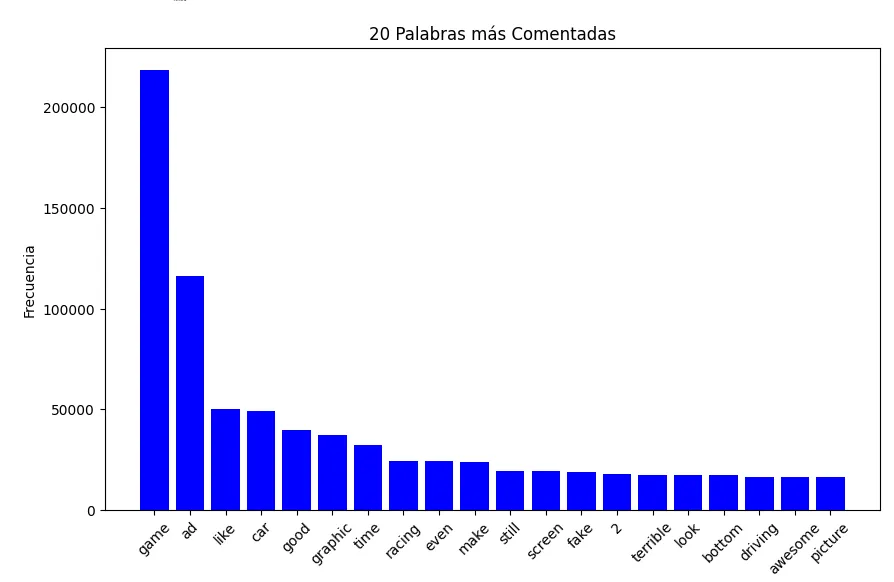
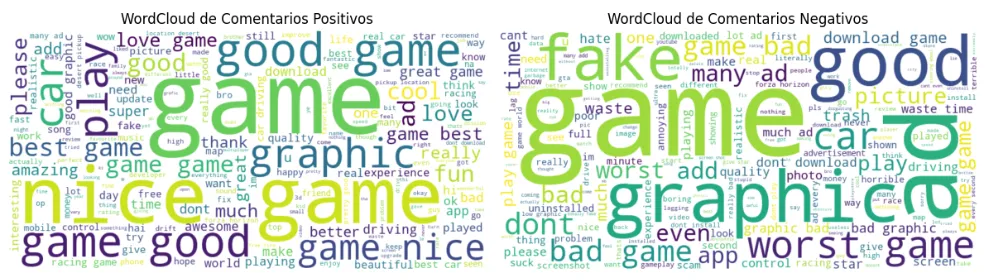
Para poder identificar rápidamente los temas y características más discutidas y relevantes para los usuarios hemos creado dos gráficos. Uno de barras con las 20 palabras más comunes del análisis y un WordCloud dividido en palabras positivas y negativas.
- Las palabras frecuentes proveen insights sobre qué es lo que les gusta, disgusta o les genera dudas a los usuarios. Orienta a los desarrolladores sobre dónde enfocar los esfuerzos de mejora en la app.
- Palabras como «terrible«, “bad” o «fake» destacan problemas técnicos a solucionar.
- Palabras como «good«, “nice” o «awesome» resaltan fortalezas a potenciar.
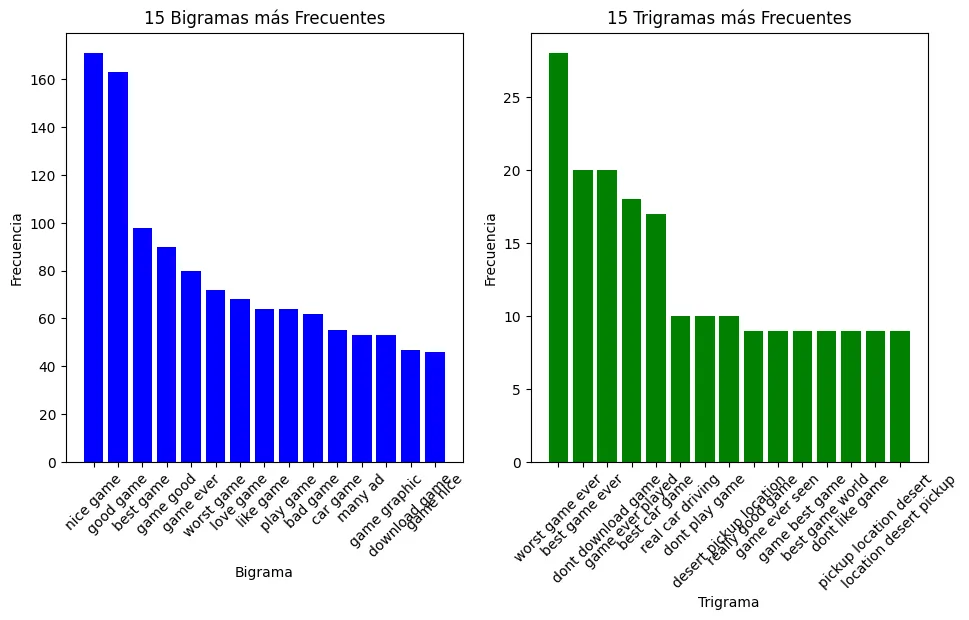
Para profundizar más en el análisis hemos apostado nuevamente por un WordCloud y unos gráficos de barras pero, en este caso, sobre bigramas y trigramas.
- Los n-gramas proveen contexto valioso que las palabras individuales no capturan.
- El wordcloud resalta visualmente las palabras o frases positivas y negativas más predominantes, lo que refuerza la identificación de fortalezas y debilidades.
- Estos capturan opiniones, necesidades y problemas más específicos. Por ejemplo «bad graphic«, «poor graphic«.
- Los trigramas resaltan temas y aspectos incluso más específicos como «way many ad» o «game graphic bad«.
- Analizar la evolución temporal de bigramas/trigramas muestra el impacto de cambios recientes.
- Bigramas/trigramas poco frecuentes pueden indicar necesidades insatisfechas de nichos de usuarios.
Estos gráficos complementarios otorgan una perspectiva más profunda sobre las experiencias y necesidades de los usuarios de la app.
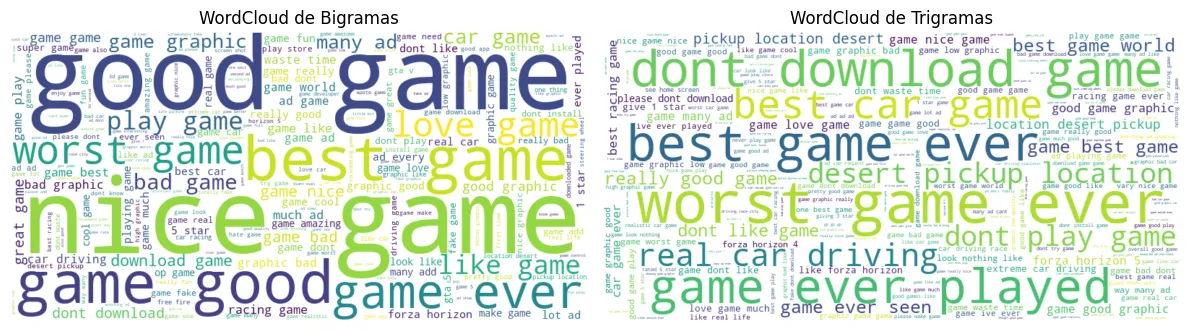
Nuestra siguiente pregunta era como podremos comprobar el engagement o si la aplicación está atrayendo usuarios. En primer lugar recurrimos a un gráfico de barras donde se observa la cantidad de comentarios que ha tenido la aplicación durante los últimos 3 meses.
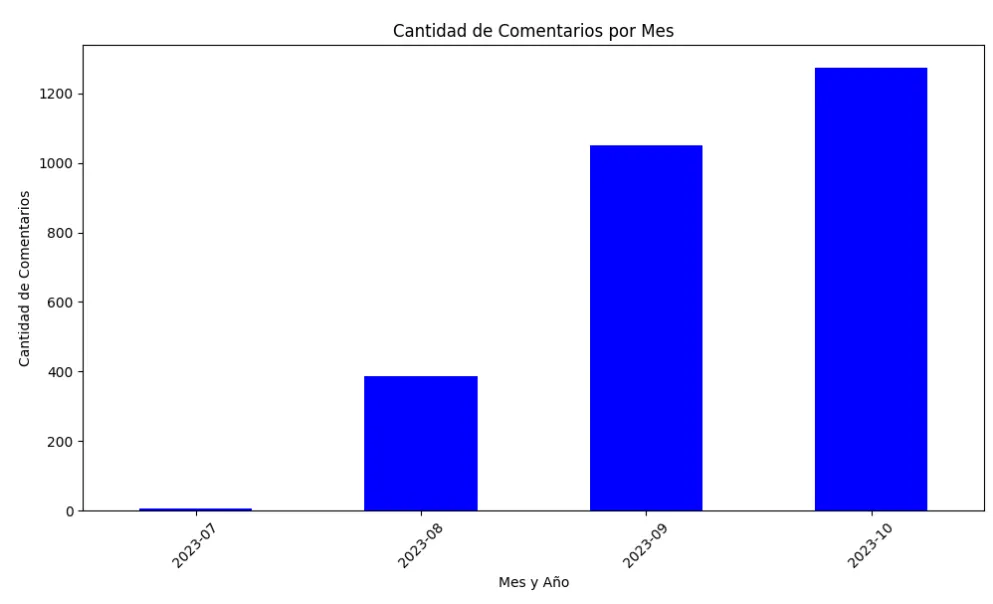
Este gráfico nos muestra que la cantidad de comentarios está en aumento constante, así que podemos inferir lo siguiente:
- La aplicación está ganando popularidad y atrayendo a más usuarios activos que dejan comentarios.
- Hay un creciente interés y engagement con la app que se refleja en más retroalimentación.
- La base de usuarios puede estar creciendo de forma orgánica o a través de iniciativas de marketing.
- Nuevas características o contenidos están impulsando que más usuarios interactúen y opinen.
- Puede indicar que la retención de la app está mejorando y los usuarios permanecen activos por más tiempo.
- La aplicación se está volviendo más relevante y valiosa para los usuarios.
- Es una señal positiva de crecimiento sostenido y satisfacción de los usuarios con la aplicación.
- Sin embargo, también podría deberse a un problema que está frustrando a los usuarios.
En nuestra opinión, el patrón observado es típicamente una indicación de expansión de la base de usuarios activos y engagement positivo. Pero es importante correlacionar este análisis con otros datos para confirmar que ese es el caso. Un análisis de sentimiento ayudaría a clarificar esto.
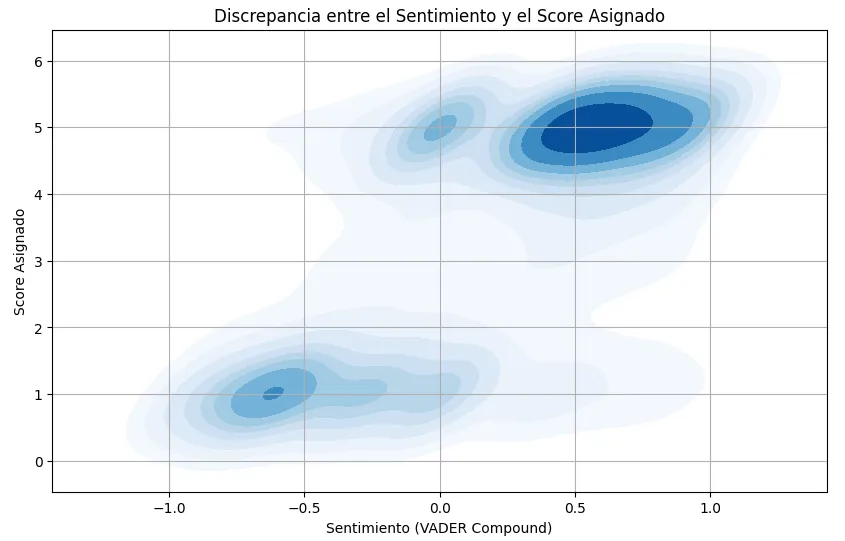
Uno de los mejores gráficos para describir y visualizar las discrepancias entre las puntuaciones y el sentimiento de los comentarios dadas por los usuarios es el gráfico de densidad bidimensional, KDE ó «Kernel Density Estimation».
Este tipo de gráficos añade densidad de puntos en ciertas zonas donde coinciden las puntuaciones y sentimientos más comunes por lo que se puede observar la correlación general entre la valoración cuantitativa (estrellas) y la evaluación cualitativa (sentimiento del comentario). En nuestro caso particular se observa una alta correlación que implica coherencia entre ambas y se confirma con la “fuerte” correlación lineal.
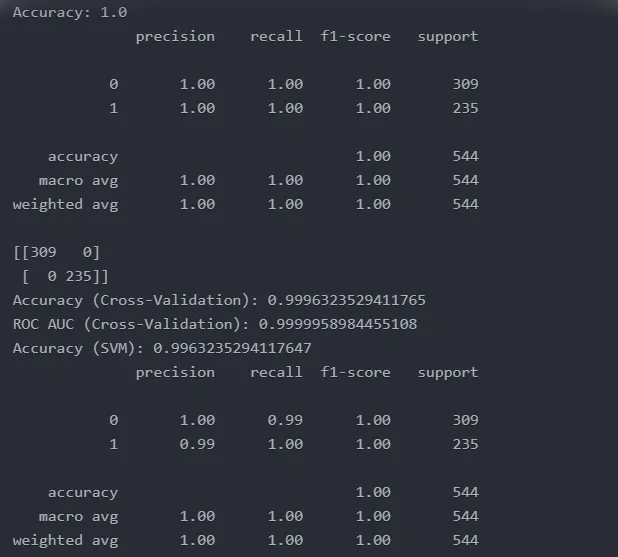
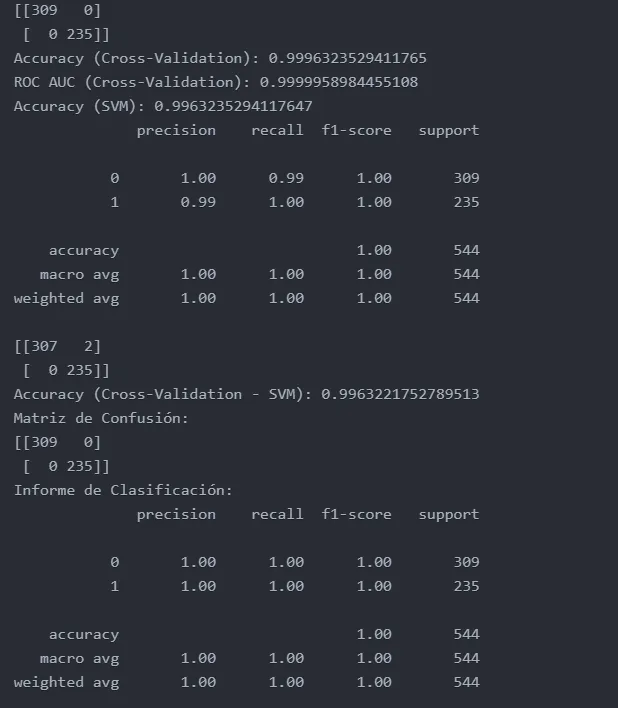
Los resultados de los modelos de clasificación aplicados a los comentarios de los usuarios nos deja varios puntos relevantes que vale la pena destacar:
- La alta precisión (accuracy) de 1.0 para Random Forest y 0.996 para SVM indica un desempeño casi perfecto de los modelos para clasificar el sentimiento.
- La precisión en cross-validation cercana a 1.0 demuestra un excelente rendimiento consistente en distintos subconjuntos de datos, lo que implica que los modelos son robustos y no overfitteados.
- Las métricas de precisión, recall y f1-score igualmente altas para ambas clases (positivo y negativo) muestran capacidad de los modelos para detectar bien ambos sentimientos.
- Las matrices de confusión con valores muy pequeños fuera de la diagonal corroboran lo anterior, con muy pocas clasificaciones erróneas.
- El área bajo la curva ROC cercana a 1 refleja una separabilidad casi óptima de las clases de sentimiento.
Con estos datos confirmados, se podrían correlacionar los dos análisis:
- La alta correlación en el gráfico KDE sugiere que existe coherencia entre la valoración cuantitativa (estrellas) y cualitativa (sentimiento) de los usuarios hacia la app.
- Esto implica que el sentimiento detectado en los comentarios es consistente con la puntuación de estrellas otorgada.
Dado que simultáneamente la cantidad de comentarios está en aumento constante…
- Es probable que este incremento refleje un crecimiento real de usuarios satisfechos, y no usuarios insatisfechos (de ser usuarios insatisfechos, se vería una discrepancia entre estrellas y sentimiento de comentarios.)
- La correlación observada indica que los usuarios en su gran mayoría es coherente entre opinión cualitativa al comentar y su puntuación cuantitativa. Por lo tanto, la tendencia creciente de comentarios se correlaciona positivamente con la satisfacción de usuarios que refleja el gráfico KDE.
En conclusión, la correlación entre métricas sugiere que el aumento en comentarios representa un crecimiento de la base de usuarios activos y satisfechos con su experiencia con la app.
Para finalizar con los resultados de esta app, planteamos el modelado con LDA para identificar los temas principales en las conversaciones de los usuarios sobre la app y obtuvimos los siguiente datos:
Perplexity: -6.511501480690985
Coherence Score: 0.36941637103297875
La perplejidad (perplexity) y la puntuación de coherencia (coherence score) son métricas que se utilizan para evaluar la calidad de un modelo de temas LDA (Latent Dirichlet Allocation).
- Perplejidad de -6.51: El modelo LDA tiene una alta capacidad de generalizar bien a nuevos datos.
- Puntuación de coherencia de 0.36: Los temas descubiertos por LDA son relativamente coherentes e interpretables.
Por lo tanto, estas métricas indican que en general se entrenó un modelo LDA de calidad razonablemente buena con los datos disponibles. Hay oportunidad de mejora incrementando la coherencia, pero la capacidad de generalización es excelente.

Basándonos en los resultados de la tabla anterior:
Se identificaron 4 temas en el conjunto de datos (Topic_0, Topic_1, Topic_2, Topic_3). Para cada tema, se presentan las palabras más representativas junto con sus respectivas probabilidades (la relevancia de esa palabra en el tema).
Tema 0 (Topic_0): Este tema se relaciona principalmente con opiniones generales y positivas. Las palabras «good«, «cool«, y «great» sugieren que muchos usuarios encuentran el juego bueno o entretenido.
Tema 1 (Topic_1): Las palabras «bad«, «graphic«, «op«, y «game» sugieren que este tema podría centrarse en opiniones que critican aspectos técnicos o gráficos del juego. Las palabras como «op» podrían referirse a algo que los usuarios consideran «overpowered» o demasiado fuerte en el juego. Además, la presencia de palabras que parecen ser jerga o términos específicos de una comunidad (como «hai», «tu», «di»).
Tema 2 (Topic_2): Este tema parece enfocarse en aspectos del juego y sus características. Las palabras «ad» y «graphic» sugieren que los usuarios están hablando de los anuncios en el juego y de la calidad gráfica. Las palabras «like«, «car«, y «play» podrían indicar opiniones sobre el juego y sus mecánicas, quizás relacionadas con algún tipo de vehículo o modo de juego en particular.
Tema 3 (Topic_3): Las opiniones extremas son la característica principal de este tema, con palabras como «best«, «worst«, y «ever«. Estas podrían ser reseñas que elogian o critican fuertemente el juego. La presencia de la palabra «ad» también sugiere que algunos comentarios podrían estar relacionados con la presencia o ausencia de publicidad en el juego.
Es importante notar que la interpretación de los temas de un modelo LDA puede ser subjetiva y, a menudo, requiere un conocimiento del contexto del conjunto de datos para ser más precisa.
Aplicación 2: Epic Merge: Magic Match Puzzle (com.matchingham.mergegame)
Se obtuvieron 533 y se analizaron 410 comentarios ya que por una parte se descartaron otros idiomas distintos del inglés. No se acotó el tiempo ya que la aplicación tiene pocos comentarios.
La puntuación promedio de los comentarios fue de 4.25 estrellas. Esto se compara con la puntuación promedio de la app en la Play Store de 4.4 estrellas.
Total de comentarios: 410
Comentarios positivos: 284
Comentarios negativos: 89
Comentarios neutros: 37
Proporción de comentarios positivos: 69.0 %
Proporción de comentarios negativos: 22.0 %
Proporción de comentarios neutros: 9.0 %
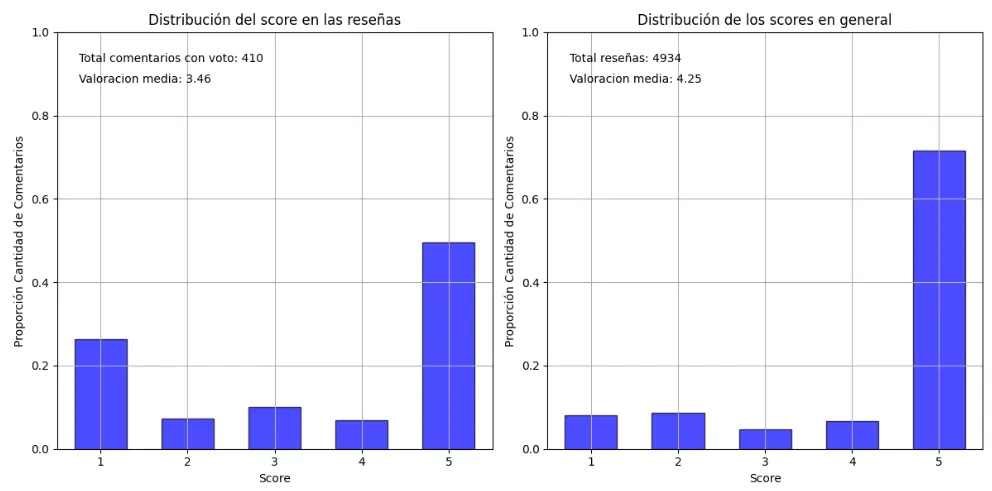
El análisis de sentimiento con VADER mostró que el 43.17% de los comentarios fueron positivos, el 19.85% negativos y en consecuencia el 36.98% fueron neutros.
Comentario más positivo : 1.0
Comentario más negativo : 0.295
Comentario más positivo: Great
Comentario mas negativo: Because the game was not loading. I ended up restarting the game and this time I am not wasting my time with the boat. Maybe I will work on the boat after all the castles are 5 Star status What is with the floaties lately? Today I hardly had any at all. Couple days ago only had floaties without the ad one, now there is hardly any. 😓
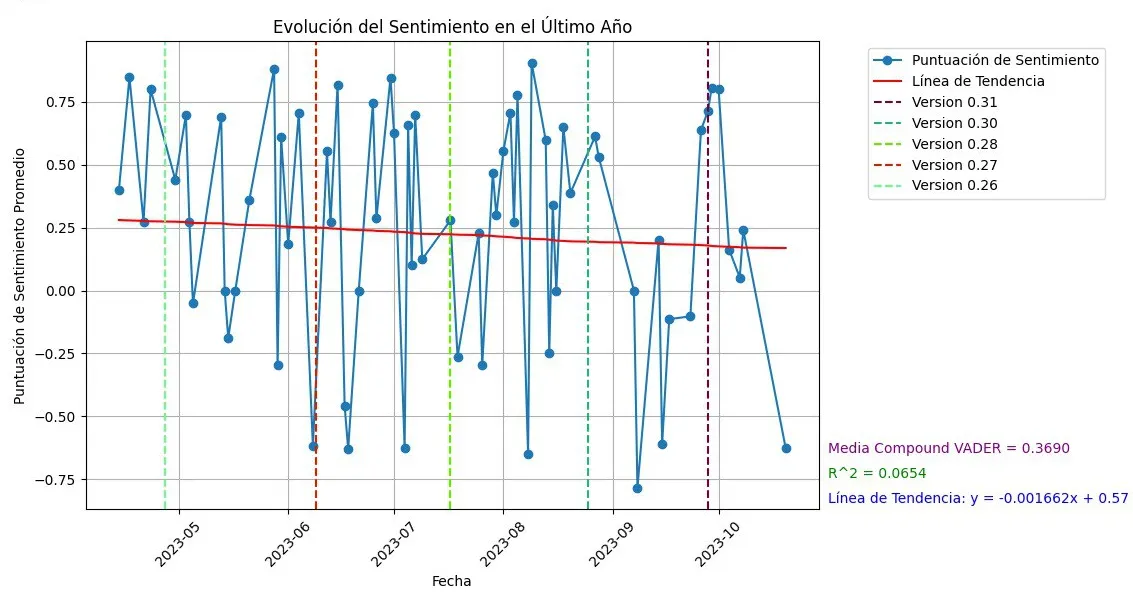
Al clasificar el sentimiento, se observó que la proporción de comentarios positivos/negativos varió a lo largo del tiempo. Sin embargo en este caso el caso es preocupante, teniendo en cuenta que la línea de tendencia es mucho más pronunciada. Este caso específico se podría interpretar así:
- Las actualizaciones y cambios realizados no han logrado mejorar la experiencia y satisfacción general de los usuarios, sugiriendo que las modificaciones implementadas no se han alineado con las necesidades y expectativas de los usuarios.
- Refleja que puede haber problemas fundamentales en la aplicación que no se están resolviendo efectivamente.
- La insatisfacción y frustración de los usuarios parece ir en aumento.
- Los esfuerzos de los desarrolladores no están dando los resultados esperados.
- Existe un desalineamiento entre la estrategia de actualizaciones y las demandas de los usuarios.
Se requiere un diagnóstico más profundo de la raíz de la insatisfacción y replantear la hoja de ruta de desarrollo. La tendencia decreciente es una poderosa señal de alarma de que se necesitan cambios importantes para revertir la creciente insatisfacción de los usuarios. Requiere una revisión urgente.
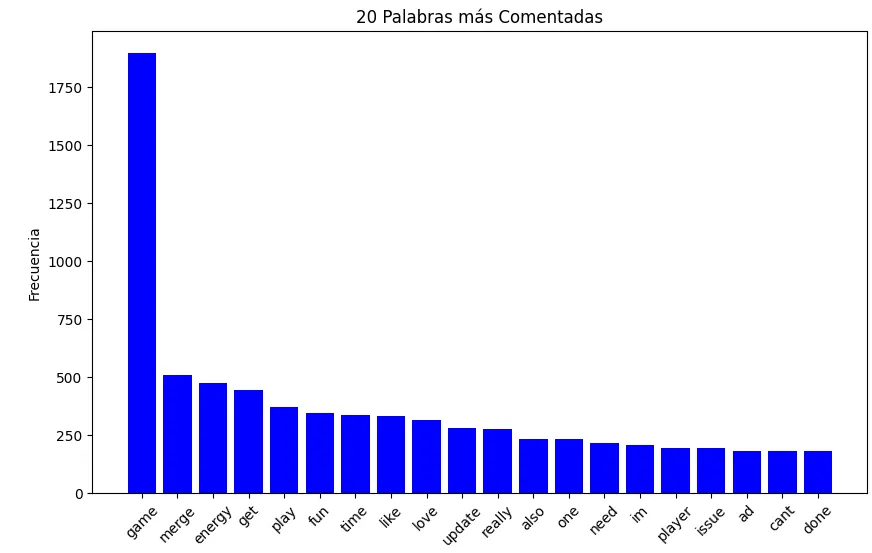
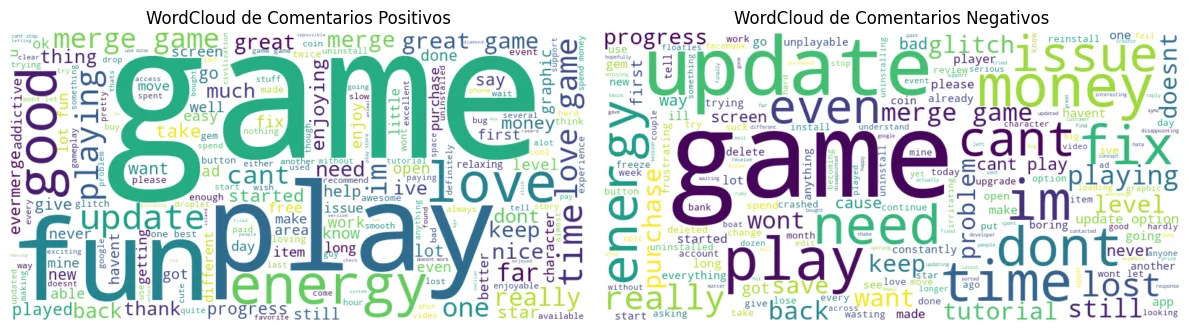
Al igual que para la aplicación anterior hemos creado dos gráficos para identificar rápidamente los temas. Uno de barras con las 20 palabras más comunes del análisis y un WordCloud dividido en palabras positivas y negativas.
- Las palabras frecuentes proveen insights sobre qué es lo que les gusta, disgusta o les genera dudas a los usuarios. Orienta a los desarrolladores sobre dónde enfocar los esfuerzos de mejora en la app.
- Palabras como «issue» o «cant» destacan problemas técnicos a solucionar.
- Palabras como «fun«, “love” o «like» resaltan fortalezas a potenciar.
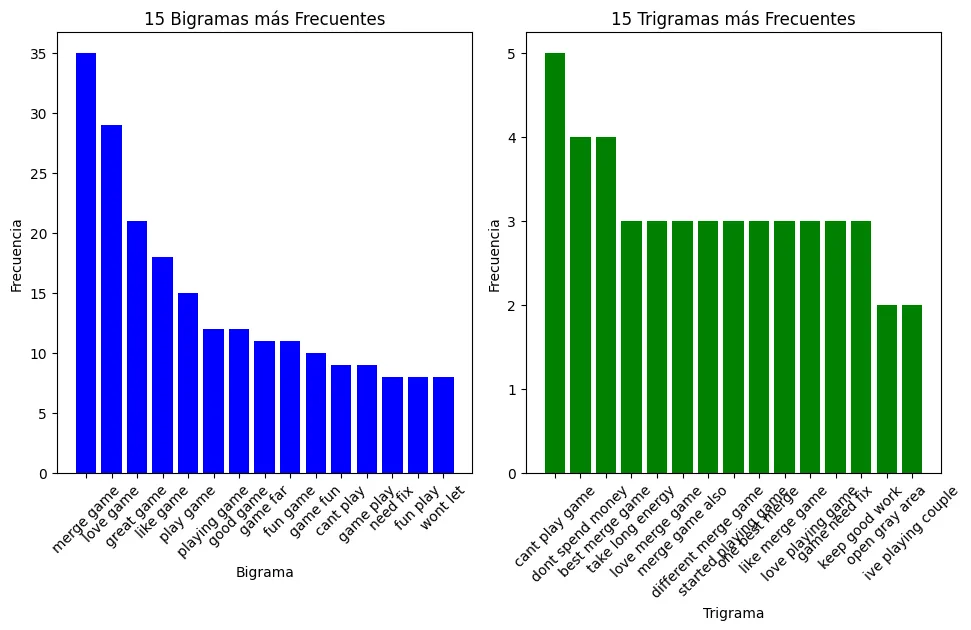
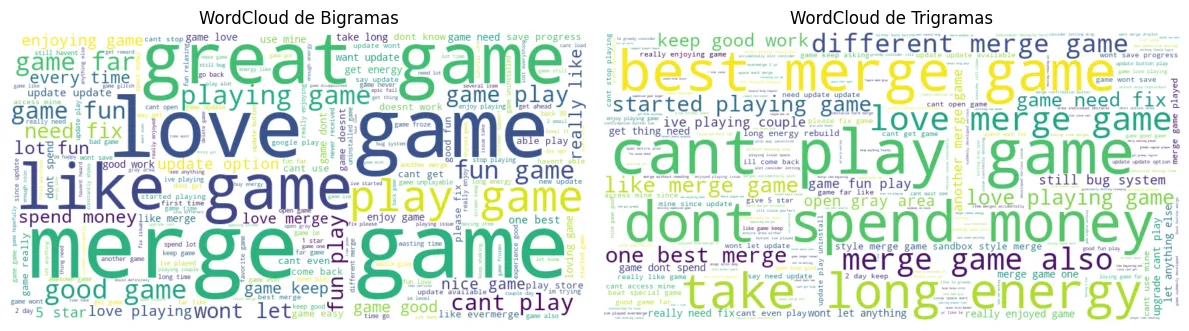
Para profundizar más usamos nuevamente un WordCloud y unos gráficos de barras sobre bigramas y trigramas.
Como ya se ha visto los n-gramas proveen contexto valioso que las palabras individuales no capturan.
- En esta app se capturaron opiniones, necesidades y problemas específicos como por ejemplo «take long«, «need fix«.
- Los trigramas resaltan temas y aspectos incluso más específicos como «cant play game«, «take long energy» o “dont spend money”.
- Analizar la evolución temporal de bigramas/trigramas muestra el impacto de cambios recientes.
Estos gráficos complementarios otorgan una perspectiva más profunda sobre las experiencias y necesidades de los usuarios de la app.
También intentamos visualizar el engagement o si la aplicación está atrayendo usuarios. Recurrimos al mismo gráfico de barras para observar la cantidad de comentarios que ha tenido la aplicación.
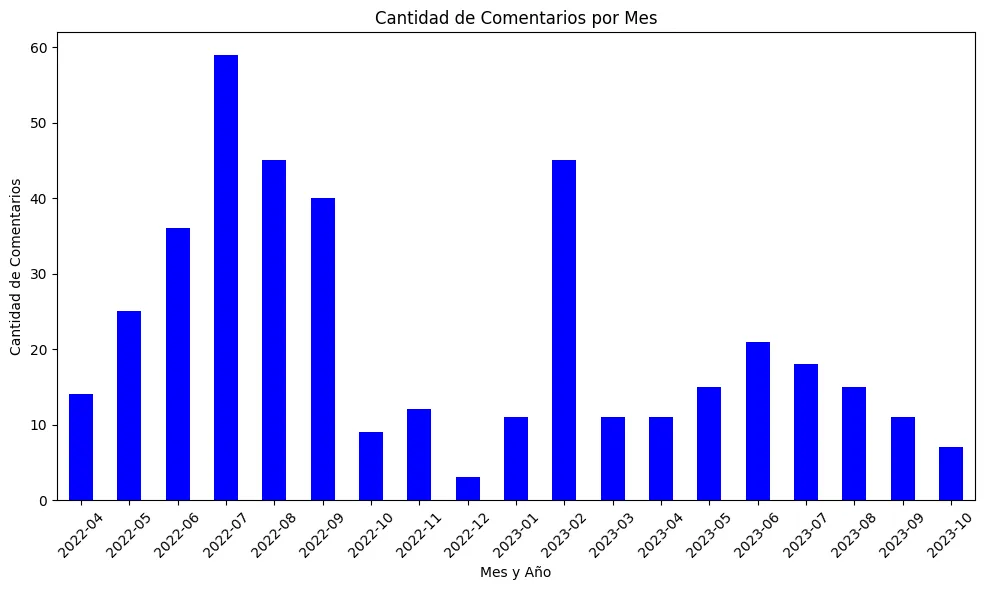
Este gráfico de barras va desde 2022-04 hasta 2023-10. A partir de él hicimos las siguientes observaciones:
- Hubo un pico significativo en la cantidad de comentarios en 2022-07, siendo el mes con la mayor cantidad de comentarios en todo el período mostrado.
- Después de 2022-07, hay una disminución gradual en los comentarios que no se vuelve significativa hasta 2023-02 donde hay otro pico en la cantidad de comentarios, aunque no tan alto como el de 2022-07.
- A partir de 2023-03, se observa nuevamente una disminución gradual en la cantidad de comentarios hasta 2023-10.
Interpretación:
El primer pico en 2022-07 podría indicar que la actualización anterior a esa fecha o el lanzamiento de un nuevo contenido en la app llevó a los usuarios a comentar más. La disminución posterior podría ser una normalización después del entusiasmo inicial o, alternativamente, problemas con la app o el contenido que disuadieron a los usuarios de comentar.
El aumento en 2022-12 podría estar relacionado con alguna actualización/promoción de fin de año o un evento en la app. El segundo pico en 2023-03 podría ser otro lanzamiento o actualización relevante que podría coincidir con eventos de primavera. La tendencia descendente después de 2023-03 sugiere que, una vez más, el interés o la actividad de los usuarios disminuyó.
Entendemos que las interpretaciones son razonables, pero especulativas. Se necesitan más datos confirmatorios para correlacionar las actualizaciones o los eventos o incluso factores externos no considerados como la seasonality, acciones de competidores o cambios en el mercado. De igual manera el próximo paso sería combinar datos cualitativos y cuantitativos para una interpretación más integral. Un análisis de sentimiento ayudaría a clarificar y complementar las interpretaciones sobre los cambios en la cantidad de comentarios a lo largo del tiempo.
Algunos puntos donde ayudaría:
- Permite validar si los picos corresponden a feedback mayormente positivo o negativo. Esto indicaría si se relacionan con satisfacción o frustración de los usuarios.
- Permite corroborar si los cambios se correlacionan más con satisfacción/frustración del usuario o con otros factores.
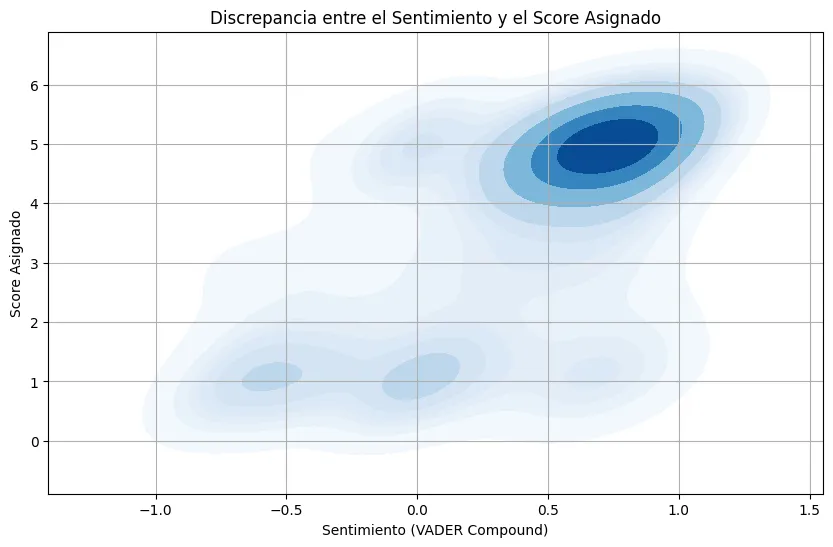
Nuevamente usaremos para visualizar las discrepancias entre las puntuaciones y el sentimiento de los comentarios dadas por los usuarios un gráfico de densidad bidimensional, KDE ó «Kernel Density Estimation».
Detallamos nuestras observaciones:
Existe una concentración mayor (color más oscuro) de datos alrededor del punto medio del sentimiento (0.0) y un score asignado de alrededor de 5. Esto sugiere que muchos comentarios con un sentimiento neutral tienden a tener un score asignado alto.
Hay una concentración secundaria de datos alrededor de un sentimiento ligeramente positivo (0.5) y un score asignado de 3.
A medida que el sentimiento es más negativo (acercándose a -1.0), hay menos datos, lo que sugiere que hay menos comentarios con un sentimiento muy negativo.
De manera similar, a medida que el sentimiento es más positivo (acercándose a 1.0), hay menos datos en los scores bajos, pero sí una ligera acumulación en los scores altos.
¿Cómo interpretamos estos datos?
La mayoría de los comentarios que tienen un sentimiento neutral o ligeramente positivo tienden a tener scores asignados altos; ocupando la mitad derecha del gráfico. Esto podría indicar que los usuarios, incluso si no expresan emociones fuertes (positivas o negativas) en sus comentarios, todavía tienden a dar calificaciones altas. En nuestro caso puede significar que le gusta el juego pero tiene cosas por mejorar.
Es interesante notar que no hay una relación lineal fuerte sino moderada entre el sentimiento y el score asignado. Por ejemplo, un sentimiento muy positivo no necesariamente se traduce en el score más alto, y un sentimiento negativo no necesariamente se traduce en el score más bajo. Esto podría deberse a que los usuarios pueden calificar basándose en otros factores además del sentimiento expresado en el comentario.
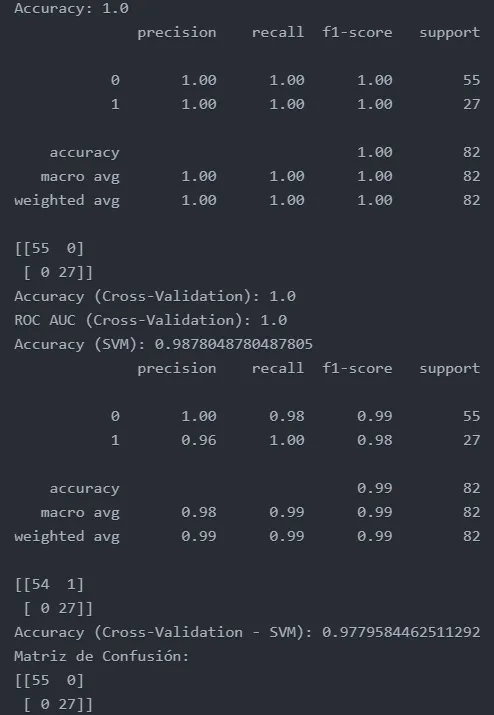
Los resultados de los modelos de clasificación aplicados a los comentarios de los usuarios nos deja varios puntos relevantes que vale la pena destacar:
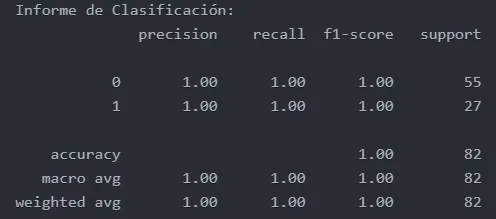
- La precisión (accuracy) de 1.0 para Random Forest indica un desempeño perfecto clasificando el sentimiento de los comentarios en la muestra de prueba.
- El accuracy de SVM es ligeramente menor (0.98) pero aún excelente, con solo 1 comentario clasificado incorrectamente de 82.
- Las métricas de precisión, recall y f1-score son igualmente altas para ambas clases, lo que muestra buen balance en el desempeño.
- Las matrices de confusión corroboran el desempeño casi perfecto, con 55 y 27 clasificaciones correctas de cada clase respectivamente.
- El accuracy de 1.0 en cross-validation implica robustez y ausencia de overfitting en Random Forest.
- El AUC ROC de 1.0 también refleja una separabilidad óptima entre clases de sentimiento. El modelo puede trazar un límite de decisión que maximiza la distancia entre clases, permitiendo una clasificación perfecta.
Sin la dimensión temporal en el gráfico KDE se limita la capacidad de correlacionar directamente con la evolución en la cantidad de comentarios. Sin embargo, aún se pueden hacer algunos análisis preliminares:
- La concentración de puntos con sentimiento neutral y scores altos, sugiere que muchos usuarios están medianamente satisfechos. Esto podría explicar un nivel mínimo de comentarios cada mes, aún sin picos de satisfacción/insatisfacción.
- La menor frecuencia de comentarios muy positivos o muy negativos indica que grandes fluctuaciones en la cantidad mensual de comentarios probablemente no se deban a euforia o frustración extrema de los usuarios.
- Dado que no hay una relación lineal “fuerte” entre sentimiento y score, es probable que los cambios en volumen de comentarios respondan a varios factores combinados, más allá de la satisfacción del usuario.
Con la información disponible hasta el momento se pueden establecer algunas hipótesis iniciales sobre la evolución en la frecuencia de comentarios, pero no es posible validarlas o correlacionarlas directamente sin incorporar el elemento temporal al análisis de sentimiento, por lo que lo vamos a incorporar en las recomendaciones a futuro.
Para finalizar utilizaremos el modelado con LDA para identificar los temas principales, de los usuarios sobre la app y obtuvimos los siguiente datos:
Perplexity: -6.62
Coherence Score: 0.36
La perplejidad (perplexity) y la puntuación de coherencia (coherence score) son métricas que se utilizan para evaluar la calidad de un modelo de temas LDA (Latent Dirichlet Allocation).
- Perplejidad de -6.61: El modelo LDA tiene una alta capacidad de generalizar bien a nuevos datos.
- Puntuación de coherencia de 0.36: Los temas descubiertos por LDA son relativamente coherentes e interpretables.
Por lo tanto, estas métricas corroboran junto al análisis anterior que en general se entrenó un modelo LDA de calidad con los datos disponibles.
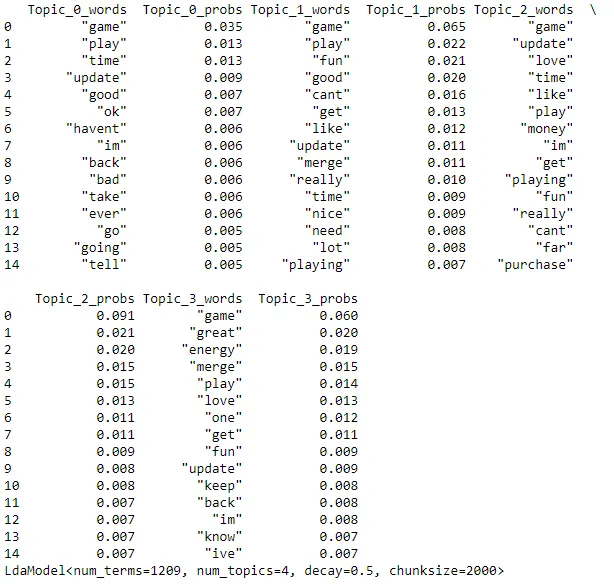
Basándonos en los resultados de la tabla anterior:
Se identificaron 4 temas en el conjunto de datos (Topic_0, Topic_1, Topic_2, Topic_3). Para cada tema, se presentan las palabras más representativas junto con sus respectivas probabilidades (la relevancia de esa palabra en el tema).
Tópico 0: Está dominado por palabras como «game», «play«, «time«, «update«, «good«. Esto sugiere comentarios generales sobre el juego, la jugabilidad, y las actualizaciones.
Tópico 1: Palabras como «game», «play«, «fun«, «good«, «cant«, y «update» sugieren opiniones sobre la diversión del juego y posiblemente problemas después de alguna actualización o limitaciones en el juego.
Tópico 2: Además de palabras generales como «game», «play«, y «time«, vemos palabras como «love«, «money«, y «purchase«. Esto podría indicar opiniones sobre microtransacciones o compras dentro de la aplicación.
Tópico 3: Las palabras «game», «great«, «energy«, «merge«, y «play» podrían indicar que hay comentarios que elogian el juego, pero también menciones sobre aspectos energéticos (quizás un sistema de energía en el juego) y algún tipo de mecanismo de fusión.
Tendencias Generales:
- La palabra «game» es prominente en todos los tópicos, lo cual es esperado ya que es una aplicación de juegos.
- Hay menciones repetidas de «update» en varios tópicos, lo que podría indicar que las actualizaciones del juego son un tema recurrente entre los usuarios, ya sea positiva o negativamente.
- La presencia de palabras como «cant«, «money«, y «purchase» podría sugerir que hay ciertos problemas o preocupaciones relacionados con las compras dentro del juego o limitaciones en el gameplay.
Conexión con Tendencias Descendentes:
- Dado que el sentimiento de los comentarios ha sido decreciente, es probable que haya habido problemas con las actualizaciones recientes o decisiones del desarrollador que no fueron bien recibidas por la comunidad.
- La disminución en la cantidad de comentarios podría ser un reflejo de una base de usuarios disminuida o menos comprometida, o podría ser que los usuarios están menos motivados para dejar comentarios si sienten que sus preocupaciones no son abordadas.
Posibles Acciones:
- Sería recomendable revisar las últimas actualizaciones y ver si hubo cambios significativos que pudieran haber afectado negativamente la experiencia del usuario.
- Si hay problemas relacionados con las compras dentro de la aplicación (microtransacciones), es importante abordar estas preocupaciones para asegurar a los usuarios que se está trabajando en soluciones.
Finalmente, para obtener una imagen más clara, sería beneficioso leer algunos comentarios completos, especialmente aquellos con sentimientos negativos, para obtener un contexto más detallado sobre las preocupaciones y opiniones de los usuarios.
Evolución prevista del proyecto
1. Mejoramiento Continuo de la Modelización:
Explorar Modelos de Machine Learning y NLP más avanzados: Considera utilizar modelos preentrenados más avanzados y técnicas de fine-tuning para mejorar la precisión y relevancia de los análisis de sentimientos y temas.
Optimización de Hiperparámetros: Continuar con la optimización de los hiperparámetros de los modelos utilizados para mejorar su rendimiento.
2. Análisis de Tendencias Temporales:
Investigar cómo los sentimientos y los temas de los comentarios cambian con el tiempo y cómo se correlacionan con las versiones y actualizaciones de la aplicación.
3. Expansión del Conjunto de Datos:
Incluir Más Plataformas: Considera incluir datos en otros idiomas y de otras plataformas aparte de Google Play, como la App Store de Apple, para tener una visión más completa.
4. Personalización de la Retroalimentación:
Análisis por Segmentos de Usuarios: Realizar análisis segmentados para diferentes tipos de usuarios y personalizar las mejoras de la aplicación según las necesidades específicas de cada segmento.
Identificación de Usuarios Clave: Identificar y dar más peso a los comentarios de los usuarios más activos o influyentes.
5. Automatización y Despliegue:
Automatización del Proceso: Implementar pipelines automatizados para recopilar, procesar y analizar nuevos comentarios en tiempo real principalmente los negativos.
Dashboards y Herramientas de Visualización: Desarrollar dashboards interactivos para que los equipos de desarrollo puedan acceder fácilmente a los insights generados.
6. Validación y Pruebas:
Pruebas A/B: Realizar pruebas A/B para validar el impacto real de las mejoras implementadas basándose en los comentarios de los usuarios.
Encuestas y Feedback Directo: Obtener feedback directo de los usuarios para validar y ajustar los insights y recomendaciones generados por el modelo.
7. Impacto Económico y de Negocio:
Medición Continua del Impacto: Implementar métricas y KPIs para monitorear continuamente el impacto económico y de negocio de las mejoras realizadas.
Análisis de Retorno de Inversión (ROI): Realizar un análisis detallado del retorno de inversión de las mejoras implementadas basándose en los comentarios de los usuarios.